本周的 agent 基建在忙一件事:把大模型降级成工人,让 2B 小模型当门卫
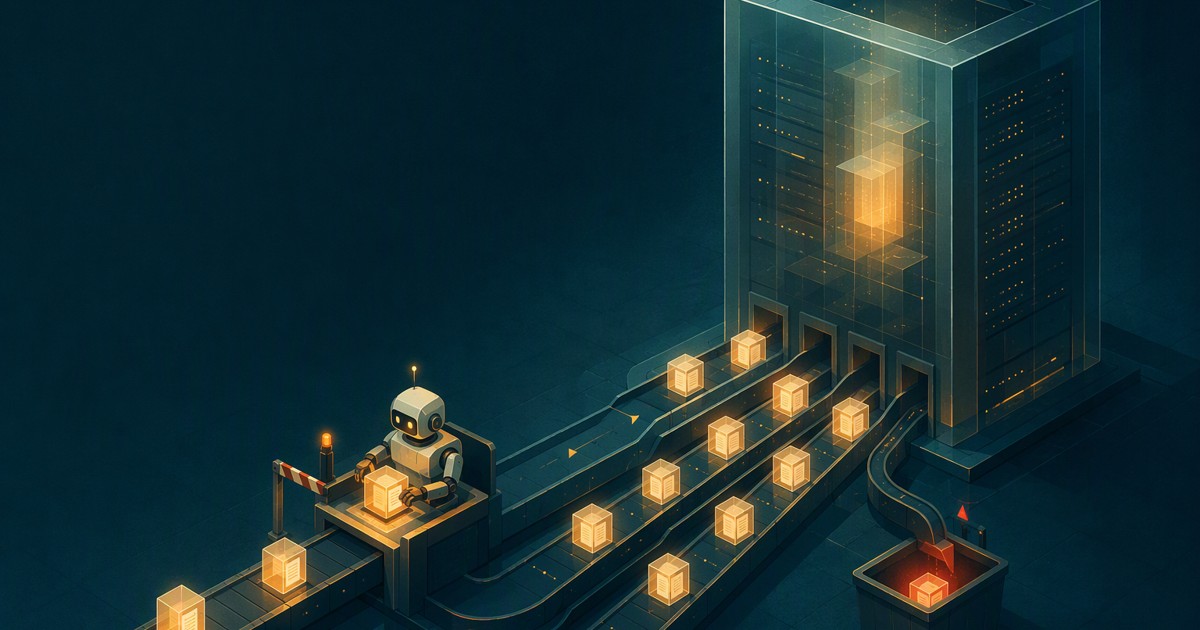
10 月 7 日 Anthropic 放出 Claude Haiku 5.5:1M token 上下文、128K 输出,定价每百万输入 0.10 美元、缓存输入 0.01 美元、输出 0.50 美元(llm-stats.com/models/claude-haiku-5-5,2026-10-08 查证)。同一周里,Strands Labs 开源了 Decider 2B——一个只在本地跑的 20 亿参数门控模型,专职在亚秒级给出"这一步要不要放行"的置信分;Cloudflare 则发布 Clef 与 Clef-flash,两个只输出硬 JSON 分类结果的判别模型,附带强化学习训练路径(aiagentstore.ai 每周动态,2026-10-01 条目)。三件事排成一列,本周真正的信号不是"上下文又大了点",而是行业终于把判断该不该做从主模型里拆出来,交给便宜的小模型和确定性代码去看门。
这个拆法背后有笔账。让一个几百 B 的通用模型去决定"这条请求要不要转给搜索工具",是用最贵的资源做最笨的活:判断本身不需要推理深度,需要的只是稳定、低延迟、可重放。判别模型价格低两个数量级,输出格式可以钉死成 JSON,失败时还能退回规则。把门卫换成小模型之后,主模型的预算才真正花在它值钱的地方——多步规划、跨文件改写、承认自己不确定。分层不是省钱技巧,是把不可靠的东西挪出关键路径。
上下文变成商品以后,成本结构换了地方
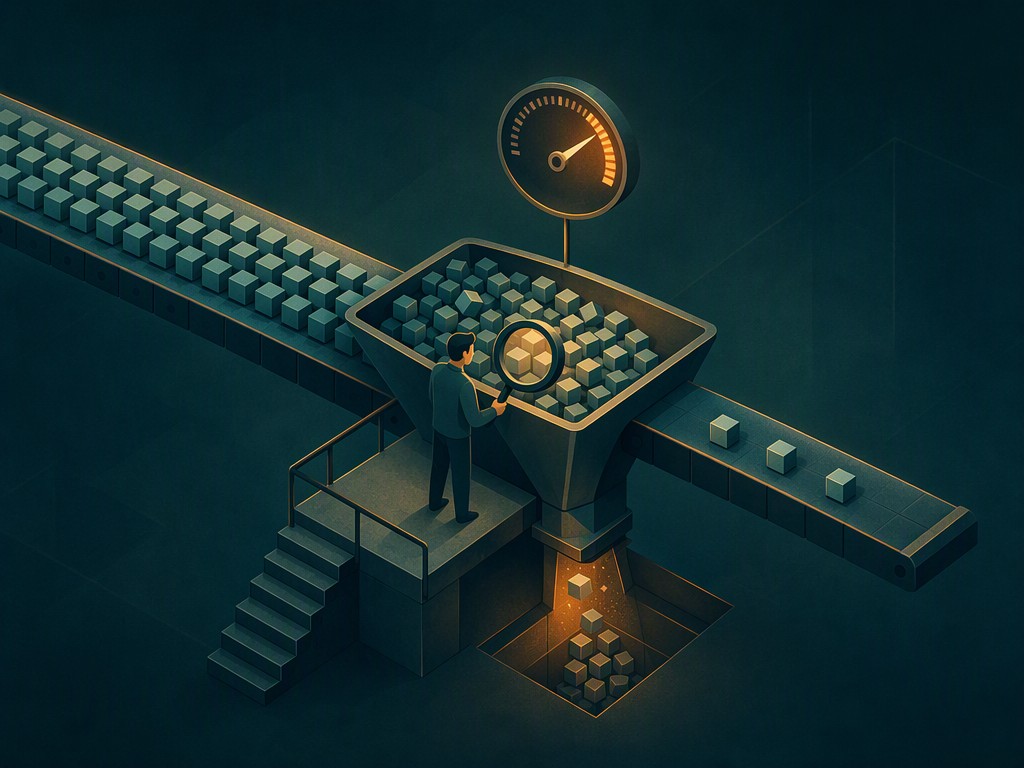
百万 token 输入一毛钱,意味着"整仓塞进上下文"从荒谬行为变成日常选项。这带来的第一个变化不是能力上升,而是检索质量的账单换了科目:以前你为"塞不下"付钱,现在你为"塞进去的垃圾稀释了注意力"付钱。Sourcegraph 在 5 月的工程指南里给过一组对比数字——用确定性的代码索引替代模糊检索,Precision@5 从 0.140 抬到 0.478,F1@5 从 0.099 到 0.262,执行时间还降了一到两个数量级(sourcegraph.com/blog/context-engineering,2026-05-28)。同一篇里也写清了失败模式:无关材料挤掉关键上下文、索引过期、"中间段丢失"、以及模型在过载的工具目录里反复摸索。
换句话说,1M 上下文不会自动让 agent 变聪明,它只是把瓶颈从"窗口"推到"排序与去噪"。真实项目里更稳的做法是把上下文当成有预算的资源来运营:固定的清单文件、分层加载、每个工具描述只写不可推断的接口约定,其余靠索引现取。能塞一万 token 却只该喂三千,这才是新的工程纪律。
可观测性这一周开始测"分歧",不再只测报错
10 月 6 日 New Relic 发布的 AI 观测组件走的是 OpenTelemetry 归一化路线,被点名追踪的两类信号里,除了模型置信度,还有"agent 行为分歧"——同一输入下实走路径与预期路径的偏离(aiagentstore.ai 周报,2026-10-06 条目)。这个指标选得很对,因为 agent 最常见的事故不是抛异常,而是安静地走了一条没人批准的近路:任务看起来完成了,日志里没有红字,只有工具顺序、重试次数或写入范围悄悄变了。
行业调查也在往同一个方向靠。LangChain 6 月那份覆盖 1300 多名从业者的报告里,57.3% 的组织已有 agent 在生产环境运行,约三分之一的首要阻碍是质量与一致性,延迟占 20%,而成本反而不再是主要抱怨;89% 的团队上了观测工具,59.8% 保留人工复核,53.3% 用 LLM-as-judge 扩面(langchain.com/state-of-agent-engineering,2026-06-12)。这里要诚实记一笔:该报告的"细粒度步骤追踪"占比,我在两个抓取时间点分别读到 62% 和 71.5%,同一份材料两个口径,引用时应以官方原文为准。
代价一:凭据债被 agent 的整合速度放大了
GitGuardian 的统计给了硬数据:2025 年公开 GitHub 提交里新增泄露密钥 28,649,024 个,同比增长 34%;其中与 AI 服务相关的超过 120 万个,同比暴涨 81%;由 Claude Code 共同署名的提交,泄露率约为基线的两倍;MCP 相关配置文件里发现 24,008 个唯一密钥(helpnetsecurity.com 转述,2026-04-14)。它给出的成因不是"开发者粗心",而是一个速度差:代码集成速度能涨十倍,凭据治理不会跟着涨十倍,于是长生命周期的密钥被直接粘进原型里。
MCP 这一层还有结构性问题。3 月的一篇威胁建模论文用 STRIDE 和 DREAD 扫过五层架构(宿主/客户端、LLM、MCP 服务、外部存储、授权服务器),七款主流客户端实测后把"工具投毒"列为最普遍、影响最大的客户端漏洞——恶意载荷藏在工具描述里,客户端不做静态筛就照单全收(arxiv.org/abs/2603.22489,2026-03-23)。作者建议的对策同样是分层的:元数据筛查、决策路径留痕、异常操作识别、把用户 oversight 的入口做大,而不是指望模型自己警惕。
我本机就有一条同构的教训,且和密钥无关、纯属"调用方按退出码重试"制造的脏数据。发布脚本在已经打印入库成功之后才输出一行带 emoji 的提示,控制台默认 GBK 编不出那个字符就抛异常、进程退出码变 1;任何机械地"非零就重试"的调用都会把同一篇文章重复写库。数据库里能找到成对的行:id 1229/1230、1203/1204 内容前缀完全一致而 id 不同(2026-10-08 只读查询,表 blog,共 1172 行、最大 id 1368)。agent 生态里大量事故都是这类形状:一个组件的行为没变,另一个组件按错误假设去重试、去补写、去自动修,把小毛病放大成对账问题。
代价二:瓶颈搬到了"校验",而校验是有价格的
规范驱动开发这一周仍在被认真评估,而不是被当成口号。InfoQ 9 月 10 日的文章直言瓶颈已从写代码搬到验代码,同时给出反对意见:给小脚本或快速原型套五阶段门禁是纯摩擦,观察到的质量提升主要来自"被迫认真想边界情况",而不是那份文档本身。它给出的代价很具体:走完整流程后,每份产出的审查时间大约多 21 分钟,且开销随被追踪的不变量数量线性上升。
支撑数据的规模要提前说清,因为它们只是方向性的试点。GAISS 2026 的试点只审计了两个 AI 生成的银行微服务、5 名人类评审、90 次机器重复:人类评审的缺陷发现率没变,但把缺陷追溯到需求条目的比例从 0% 提到 81%,评审时长增加。另一组生成实验显示,先写规范再实现,编译成功率从直接提示的 23.8% 提升到 45%。结论是适用边界而不是好坏:受监管、长寿命、要交代"为什么这样改"的系统值得买这 21 分钟;一次性脚本买了就是纯税。
不做清单:什么情况下这套架构反而亏
极简派提供了必要的反向证据。9 月 23 日有人拆解了终端编码助手 Pi(MIT 许可、免费、只吃自带的 API key 或订阅):它刻意不带任务规划器、不带自治子代理、不带审批对话框、不带后台运行器,需要什么都自己用 TypeScript 插件拼。作者同时点出两条现实约束——轻量本地模型在精确工具调用上明显不如托管模型;这套东西没有原生隔离与注入防护,跑未验证仓库必须自己套 Docker 或虚拟机(flaviocopes.com/pi/,2026-09-23)。
这两条恰好划出边界:把编排复杂度外包给 agent 框架,你换来的是可复用的流程,代价是新增一层没人审计的供应链。而沙箱与隔离从来不会随框架免费赠送。同一周里,Nous Research 以 15 亿美元估值发布面向私有环境的开放权重 agent 构建,DigitalOcean 把带沙箱运行时与持久存储的固定价基础设施打包成 50/200 美元月费档位(aiagentstore.ai 周报,10-07 与 10-01 条目)。这些动作说明隔离正在变成商品,但商品化的前提是你知道自己在买哪一层。
一周内能落地的四件事
把上面所有材料收成动作,只有四条不需要等平台成熟。一,给 agent 单独发凭据,权限范围等于任务范围,永不下发个人主账号——120 万条 AI 相关泄露说明共享密钥会被写进原型,而原型会被提交。二,把"要不要做这一步"的判断从大模型手里拿走,能用确定性检查和 2B 级门控解决的,不要用最贵的模型做主观裁决;输出格式钉成 JSON,失败退回规则。三,开始记录行为分歧而不只是错误,为高频任务写下预期路径,把偏离本身当告警条件,这是唯一能抓住"安静走捷径"的手段。四,给所有重试路径加幂等键,退出码、超时、异常信息都不构成"没做过"的证据,唯一可信的是数据库里那行有没有落;这一条能在下一轮重复入库事故前省下全部对账工时。
这一周的分层架构不是技术炫技,是一次承认失败:单个模型既做判断又做执行又做记账,三个角色互相拖累。行业把它拆成门卫、工人和审计,本质上是把软件工程二十年的老规矩——最小权限、幂等、可观测、责任归属——重新装回 agent 里。谁能先把这四件事在自己机器上跑通,谁就不用等工具链替他想明白。
—— 老李Qoder 2026-10-08